Сервер для нейросети подбирают не по числу ядер и не по цене, а по объёму видеопамяти — VRAM: именно она определяет, влезет модель в машину или нет. Запуск уже готовой модели называют инференсом: нейросеть только отвечает на запросы, а не учится. Языковой модели на 7 миллиардов параметров (сокращённо 7B) в 4-битном сжатии для инференса достаточно примерно 6 ГБ VRAM, модели 13B — около 10 ГБ, а 70B — уже порядка 40 ГБ. Всё остальное — процессор, оперативная память, диск — подбирается под эту цифру, и в каталоге VPS с видеокартой конфигурации отсортированы именно по ней. А часть задач вообще обходится без видеокарты, и это самый недооценённый сценарий.
Материал для тех, кто впервые арендует машину под ИИ-задачи: разработчика с чат-ботом на своей модели или владельца сервиса распознавания документов. Разберём, сколько VRAM нужно под разные модели, чем инференс отличается от обучения, сколько места съедают веса и где проходит граница между GPU- и CPU-сервером.
Инференс и обучение — две разные задачи с разными требованиями к железу
Нейросеть живёт в двух режимах, и путать их дорого. Инференс — это работа уже обученной модели: вы отправляете запрос, модель считает ответ. Обучение (и его облегчённая версия — дообучение, fine-tuning) — это подгонка весов модели под ваши данные, процесс на порядок более тяжёлый.
Разница в требованиях кратная. Обучение той же модели требует в 3–4 раза больше видеопамяти, чем инференс, потому что кроме самих весов в память нужно уложить градиенты, состояния оптимизатора и промежуточные активации. Модель, которая спокойно отвечает на 6 ГБ VRAM, для полноценного дообучения запросит уже 20–24 ГБ.
Практический вывод: 9 из 10 задач малого бизнеса — это инференс. Готовая модель отвечает по базе знаний, рисует картинки для карточек товаров или расшифровывает записи звонков. Обучать с нуля никто не собирается, а значит, и платить за сервер уровня обучения не нужно.
Если вы всё же планируете дообучение под свои данные, начните с самого экономного варианта — LoRA. Этот метод подгоняет не всю модель, а небольшой набор дополнительных матриц, и вписывается в 12–16 ГБ VRAM там, где полное дообучение модели 7B потребовало бы около 48 ГБ.
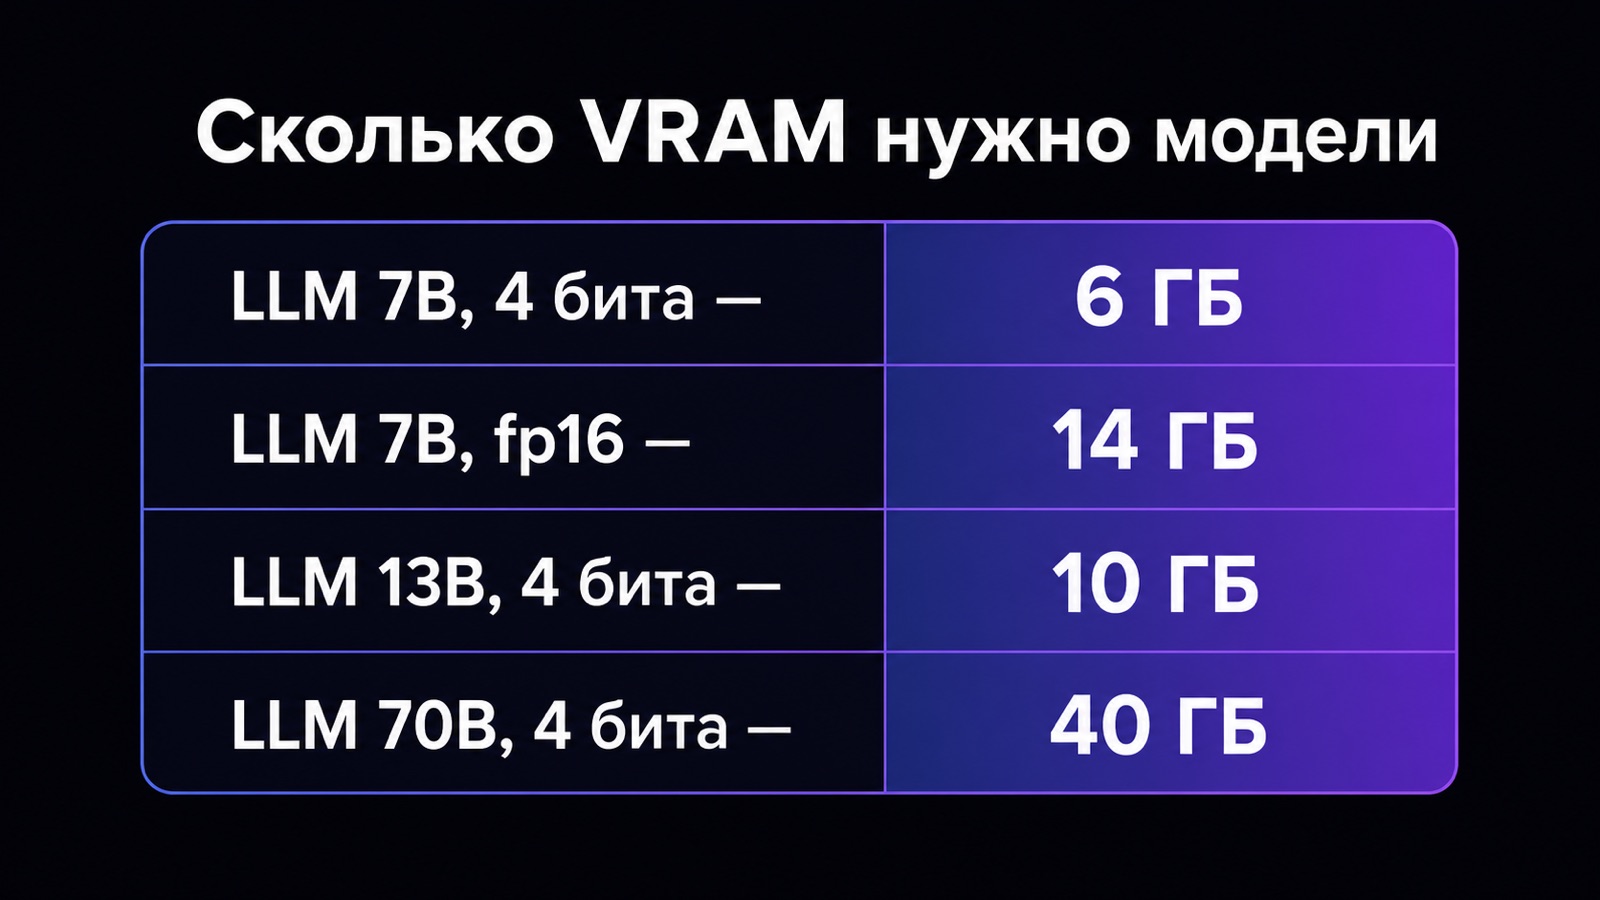
VRAM: сколько видеопамяти нужно под конкретную модель
Видеопамять — ресурс, которого либо хватает, либо нет. Если модель не помещается в VRAM целиком, она выгружается в обычную оперативку, и скорость падает в 10–30 раз: ответ вместо 2 секунд приходит за минуту.
Объём считается от числа параметров и разрядности. В формате fp16 каждый параметр занимает 2 байта, то есть модель на 7 миллиардов параметров — это около 14 ГБ. Квантизация (сжатие весов до меньшей разрядности) режет это число: в 8 битах остаётся ~7 ГБ, в 4 битах — ~4 ГБ плюс запас на контекст, итого около 6 ГБ.
Генеративные картиночные модели устроены иначе, но логика та же. Stable Diffusion 1.5 запускается от 6 ГБ VRAM, более тяжёлая SDXL — от 10 ГБ. На потребление здесь сильно влияет разрешение картинки: та же SDXL на 512×512 и на 1024×1024 просит заметно разные объёмы.
| Модель / задача | Разрядность | VRAM на инференс | VRAM на дообучение |
|---|---|---|---|
| LLM 7B | 4 бита | ~6 ГБ | от 20 ГБ |
| LLM 7B | fp16 | ~14 ГБ | от 48 ГБ |
| LLM 13B | 4 бита | ~10 ГБ | от 32 ГБ |
| LLM 70B | 4 бита | ~40 ГБ | от 140 ГБ |
| Stable Diffusion 1.5 | fp16 | от 6 ГБ | от 18 ГБ |
| SDXL | fp16 | от 10 ГБ | от 30 ГБ |
Когда GPU не нужен вообще: задачи для обычного CPU-сервера
Видеокарта (её же называют GPU) нужна там, где модель большая и ответ должен приходить быстро. Как только одно из двух условий отпадает, GPU превращается в переплату. Небольшие модели на CPU работают вполне сносно, а фоновые задачи вообще не требуют мгновенности.
Классификатор текста, детектор спама, модель распознавания речи на коротких файлах, эмбеддинги для поиска по базе знаний (так называют числовые «отпечатки» текста, по которым система ищет похожие по смыслу фрагменты) — всё это спокойно живёт на 4–8 ядрах без видеокарты. Языковая модель на 1–3 миллиарда параметров в 4-битном сжатии на современном процессоре выдаёт 5–15 токенов в секунду. Токен — это кусочек слова, и 10 токенов в секунду примерно равны скорости неторопливой печати: для чата медленно, для ночной обработки очереди из 500 документов — нормально.
Отдельный сценарий — когда сама модель крутится в чужом облаке, а вам нужен только сервер под приложение, которое к ней ходит по API. Телеграм-бот, веб-интерфейс, очередь задач — под них хватит обычного VPS под Python за 150–300 ₽/мес, и никакая VRAM ему не нужна.
Категорию задачи определяет один вопрос: сколько секунд пользователь готов ждать ответа? Меньше пяти — нужна видеокарта. Если задача фоновая и результат забирают через минуты, берите обычный виртуальный сервер без GPU.
Оперативная память и ядра: сколько брать, если видеокарта уже есть
Обычная оперативная память на GPU-сервере выполняет вспомогательную роль, но её нехватка ломает запуск. Модель сначала читается с диска в оперативную память и только потом переезжает в видеопамять. Если RAM меньше размера файла весов, процесс упадёт на загрузке.
Рабочее правило — оперативки не меньше, чем видеопамяти, и лучше в 1,5 раза больше. Под 8 ГБ VRAM берите 12–16 ГБ RAM, под 24 ГБ VRAM — 32 ГБ и выше. Для CPU-инференса требование жёстче: там модель целиком живёт в оперативке, и 7B в 4 битах займёт те же ~6 ГБ плюс место под систему и приложение.
С процессором проще. При работе с GPU он занят подготовкой данных и токенизацией, и 4–8 виртуальных ядер хватает почти всегда. Исключение — обработка изображений и видео перед подачей в модель: там CPU становится узким местом, и 8–16 ядер оправданы.
Отдельно проверяйте, гарантированные ли ядра вам продают. На дешёвых тарифах с burstable-CPU (процессором «со всплесками») полная частота доступна лишь короткими рывками, а дальше скорость режется — для ровной многочасовой нагрузки это плохой вариант.
Диск: сколько места реально съедают веса моделей
Диск недооценивают чаще всего, а заканчивается он первым. Веса модели 7B в fp16 занимают 13–14 ГБ, и это один файл одной модели. Скачаете три-четыре варианта для сравнения — 100 ГБ уйдут незаметно.
К весам добавляются кэши библиотек: старые версии файлов они не удаляют автоматически. Плюс образы контейнеров — базовый образ с драйверами видеокарты и фреймворком весит 8–15 ГБ ещё до вашего кода.
По скорости диска требование одно: NVMe, а не SATA-SSD и тем более не HDD. Модель на 14 ГБ с NVMe загружается в память за 10–20 секунд, с обычного HDD — несколько минут. Это критично не в обычной работе, а при перезапусках: каждое обновление кода превращается в долгую паузу.
| Что храним | Объём | Комментарий |
|---|---|---|
| Веса LLM 7B, fp16 | 13–14 ГБ | Базовый формат без сжатия |
| Веса LLM 7B, 4 бита | 4–5 ГБ | Формат GGUF или аналог |
| Веса LLM 13B, 4 бита | 7–8 ГБ | Плюс место под контекст в RAM |
| Stable Diffusion 1.5 | 4–7 ГБ | Один чекпоинт |
| SDXL + refiner | 13–15 ГБ | Две модели в связке |
| Образ контейнера с драйверами | 8–15 ГБ | До вашего кода |
| Рекомендуемый минимум диска | 80–100 ГБ | Одна модель + система + запас |
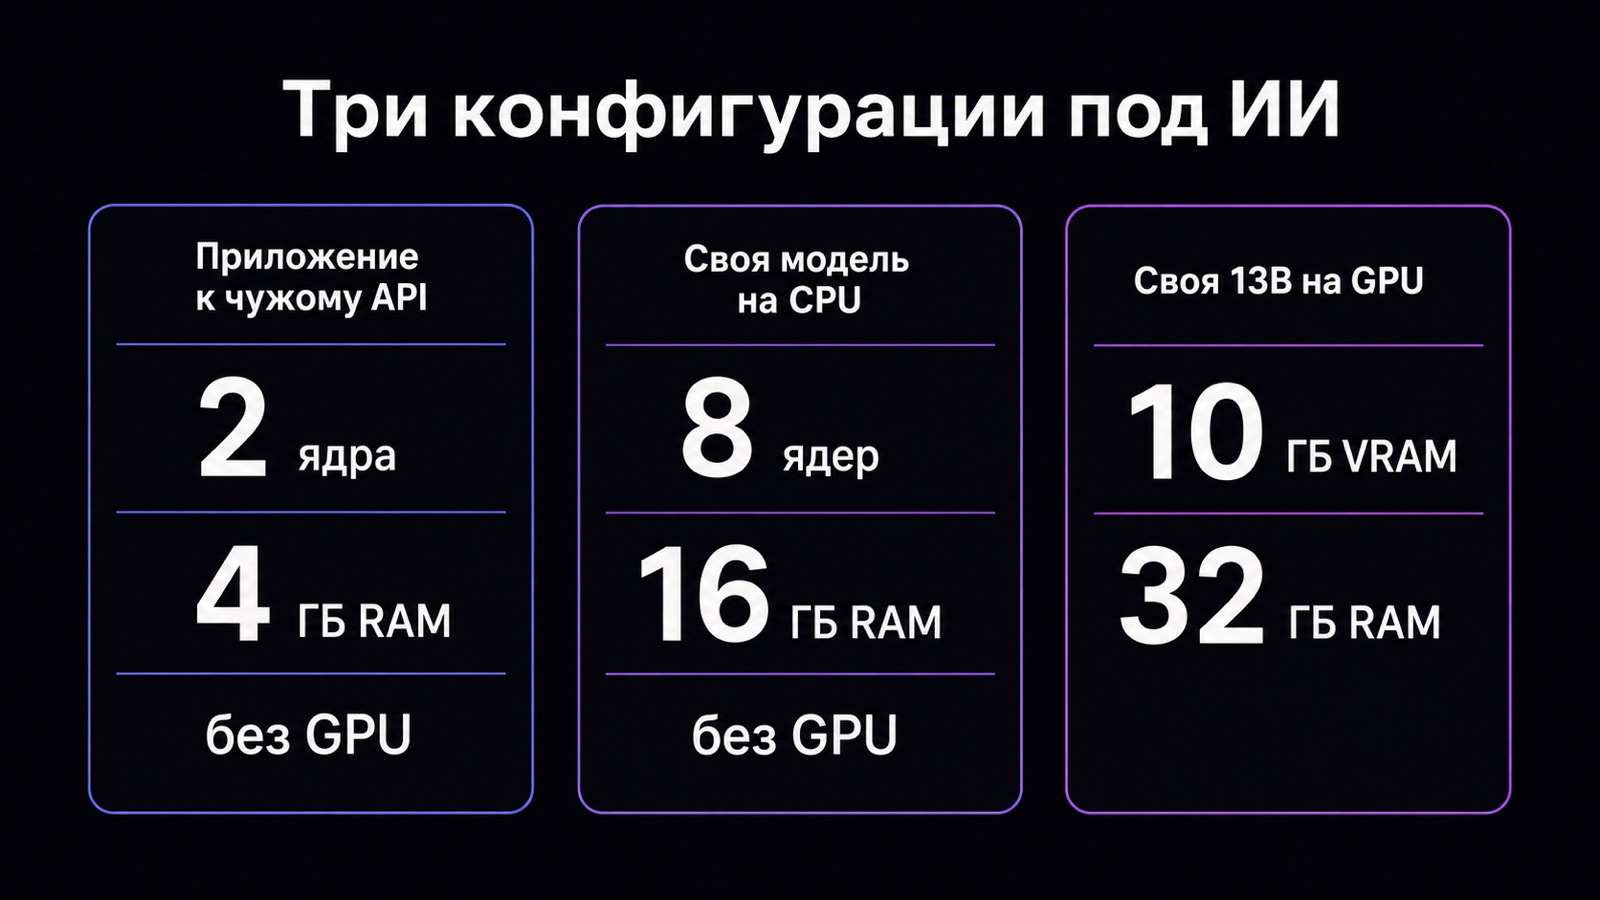
Три типовые конфигурации: от бота на API до собственной 13B
Чтобы не считать каждый параметр заново, держите в голове три готовых профиля. Они покрывают почти все запросы читателей и отличаются друг от друга примерно на порядок по стоимости.
Первый профиль — приложение без своей модели: бот, парсер или веб-интерфейс, который ходит в чужой API. Второй — небольшая своя модель на CPU для фоновых задач. Третий — полноценный GPU-сервер под интерактивный инференс, когда ответ нужен за секунды и трафик идёт постоянно.
| Профиль | vCPU / RAM / диск | GPU | Типичная задача |
|---|---|---|---|
| Приложение к чужому API | 2 ядра / 4 ГБ / 40 ГБ NVMe | не нужен | Телеграм-бот, веб-интерфейс |
| Своя модель на CPU | 8 ядер / 16 ГБ / 100 ГБ NVMe | не нужен | Эмбеддинги, классификация, ночная очередь |
| Интерактивный инференс 7–13B | 8 ядер / 32 ГБ / 200 ГБ NVMe | от 12 ГБ VRAM | Чат по базе знаний, генерация картинок |
Сколько стоит сервер под ИИ-задачи в 2026 году
Разброс цен огромный, потому что за одним словом «сервер» скрываются машины, отличающиеся в сотню раз. Начальные CPU-конфигурации в каталоге серверов под ИИ-задачи, где собрано 44 провайдера, стартуют с двузначных сумм — это как раз профиль «приложение к чужому API».
Для профиля «своя модель на CPU» ориентируйтесь не на стартовую строчку прайса, а на тариф с 8 ядрами и 16 ГБ памяти — обычно это 1500–4000 ₽/мес в зависимости от провайдера и локации. GPU-конфигурации живут в другой лиге, там счёт идёт на десятки тысяч рублей в месяц, и почасовая аренда часто выгоднее месячной.
| Провайдер | Стартовая цена | Стартовая конфигурация | Тарифов в каталоге |
|---|---|---|---|
| Cloudcore | от 59 ₽/мес | 1 ядро, 1 ГБ, 10 ГБ NVMe | 12 |
| Hosting-Russia | от 99 ₽/мес | — | — |
| HostVDS | от 127 ₽/мес | 1 ядро, 1 ГБ, 10 ГБ NVMe | 12 |
| RuVDS | от 139 ₽/мес | 1 ядро, 0,5 ГБ, 10 ГБ HDD | 440 |
| 4VPS | от 110 ₽/мес | 1 ядро, 1 ГБ, 5 ГБ NVMe | 568 |
| Selectel | от 200 ₽/мес | 1 ядро, 1 ГБ, 10 ГБ NVMe | 69 |
| Aéza | от 593 ₽/мес | 1 ядро, 2 ГБ, 30 ГБ NVMe | 151 |
Данные проверены 03.09.2026.
Стартовые тарифы из таблицы — не машины под нейросети, а точка отсчёта по ценам провайдера. Конфигурацию под свою задачу считайте по профилям выше, а подборки посильнее собраны в обзоре VPS с видеокартой.
Пошагово: как подобрать конфигурацию под свою модель
Порядок действий имеет значение: начнёте с выбора провайдера вместо расчёта VRAM — через неделю придётся менять тариф. Пройдите пять шагов по очереди, каждый отсекает часть вариантов.
Записывайте получившиеся числа — в конце выйдет готовый набор фильтров для каталога. Ошибиться в большую сторону дешевле: расширить тариф можно за минуты, а переезд к другому провайдеру съест полдня.
- Определите модель и разрядность. Например: LLM 7B в 4-битной квантизации. Из таблицы выше берём 6 ГБ VRAM.
- Добавьте запас на контекст. Длинный диалог на 8000 токенов добавляет 1–2 ГБ. Итого нужна видеокарта минимум на 8 ГБ.
- Посчитайте RAM. Полтора объёма VRAM: 8 × 1,5 = 12 ГБ, округляем вверх до 16 ГБ.
- Посчитайте диск. Веса 5 ГБ + образ 12 ГБ + система 15 ГБ + запас на вторую модель — берём 100 ГБ NVMe.
- Выберите локацию и провайдера. Если пользователи в России, дата-центр в Москве или Петербурге даст задержку 5–15 мс против 40–60 мс из Европы.
Развернуть саму модель после этого — отдельная история, и мы разобрали её пошагово в гайде о запуске LLM на сервере. Там же описан вариант с Docker, который избавляет от ручной установки драйверов и библиотек.
Сеть, задержка и режим оплаты
Трафик у нейросетевых задач скромный: запросы и ответы весят килобайты, и канала на 100 Мбит/с хватает даже при сотне одновременных пользователей. Исключение — генерация изображений, где каждый результат весит 1–5 МБ.
А вот задержка сети важна для интерактивных сценариев. К времени работы самой модели добавляется время в пути: 5–15 мс до российского дата-центра или 40–60 мс до европейского. На фоне ответа за 2–3 секунды это мелочь, но при потоковой выдаче токенов разница ощущается.
Режим оплаты выбирайте до запуска. Эксперименты и разовое дообучение дешевле брать почасово: 20 часов работы GPU-машины обойдутся в разы меньше месячного тарифа. Постоянный сервис выгоднее держать на месячной оплате.
Если вы разворачиваете языковую модель как основной сервис, посмотрите профильный раздел серверов под LLM — там фильтры сразу настроены на конфигурации с достаточным объёмом памяти. Для тяжёлого обучения смотрите выделенные серверы с GPU: там видеокарта не делится между арендаторами.
Частые ошибки при выборе сервера под нейросеть
Большинство неудачных покупок укладывается в несколько повторяющихся сценариев. Их объединяет одно: человек считал ресурсы «на глаз», а не по размеру модели. Ниже — то, что чаще всего приходится исправлять уже после оплаты.
Самая дорогая ошибка — аренда GPU-машины «на всякий случай»: разница между CPU-тарифом за 300 ₽/мес и GPU-сервером в десятки тысяч рублей несопоставима с выигрышем на фоновой задаче.
- Берут сервер с видеокартой под задачу, которая спокойно живёт на CPU, и переплачивают в 30–50 раз.
- Считают VRAM ровно по размеру весов и забывают 1–2 ГБ на контекст — модель падает на длинных диалогах.
- Экономят на диске: 40 ГБ заканчиваются после второй модели и первого образа контейнера.
- Ставят RAM меньше объёма весов, и модель не может даже загрузиться с диска.
- Берут HDD вместо NVMe и получают многоминутный старт при каждом перезапуске.
- Не проверяют, гарантированные ли ядра, и упираются в ограничение burstable-CPU под ровной нагрузкой.
Всё это проверяется до оплаты: у многих провайдеров есть почасовой тариф, где сутки аренды стоят десятки рублей. Разверните модель, погоняйте полдня под реальной нагрузкой и только потом переходите на месячную оплату.
Частые вопросы
Можно ли запустить нейросеть на обычном VPS без видеокарты? Да, если модель небольшая и скорость некритична. LLM на 1–3 миллиарда параметров в 4-битном сжатии на 8 ядрах выдаёт 5–15 токенов в секунду, чего хватает для фоновой обработки очереди. Для интерактивного чата этого мало — пользователь будет ждать ответ десятки секунд.
Сколько видеопамяти нужно для модели на 7 миллиардов параметров? В 4-битной квантизации — около 6 ГБ, в fp16 — примерно 14 ГБ. К этому добавьте 1–2 ГБ на контекст диалога, поэтому практический минимум для комфортной работы — видеокарта на 8 ГБ VRAM.
Хватит ли 16 ГБ оперативной памяти для нейросети? Для инференса моделей до 13B в 4-битном формате — да, с запасом. Для CPU-инференса модели 7B в fp16 уже нет: одни только веса займут 14 ГБ, и системе ничего не останется. Ориентируйтесь на правило «RAM в полтора раза больше объёма весов».
Чем аренда отличается от покупки своей видеокарты? Своя карта окупается только при постоянной круглосуточной загрузке в течение года и больше. Для экспериментов и нерегулярных задач аренда дешевле: вы платите за часы работы, а не за простаивающее железо, и в любой момент меняете конфигурацию.
Сколько места на диске занимает языковая модель? Веса 7B в fp16 — это 13–14 ГБ, в 4-битном формате — 4–5 ГБ. Модель 13B в 4 битах займёт 7–8 ГБ. К этому прибавьте 8–15 ГБ на образ контейнера с драйверами и библиотеками, поэтому диск меньше 80 ГБ брать не стоит.
Нужен ли отдельный сервер, если модель работает в чужом облаке? Нужен обычный VPS без видеокарты — под ваше приложение, которое ходит в API и хранит историю диалогов. Хватает 2 ядер, 4 ГБ RAM и 40 ГБ диска — это тарифы за 150–300 ₽/мес.
Можно ли дообучить модель на арендованном сервере? Да, но требования к видеопамяти вырастут в 3–4 раза относительно инференса. Экономный вариант — метод LoRA: он укладывается в 12–16 ГБ VRAM там, где полное дообучение 7B потребовало бы около 48 ГБ.
Где посмотреть подробные требования к железу под разные ИИ-задачи? Мы собрали отдельный разбор в материале о требованиях сервера для ИИ, где расписаны конфигурации под распознавание речи, компьютерное зрение и работу с документами.
Итог
Расчёт начинается с одной цифры — объёма модели в выбранной разрядности. Из неё выводятся VRAM (объём весов плюс 1–2 ГБ на контекст), оперативная память (в полтора раза больше VRAM) и диск (не меньше 80–100 ГБ NVMe). Если ответ нужен не мгновенно или модель небольшая, видеокарта не нужна вовсе — и это экономит десятки тысяч рублей в месяц.
Подобрать конкретный тариф под посчитанную конфигурацию удобнее в разделе серверов для нейросетей: там 44 провайдера с фильтрами по памяти, диску и локации, а цены обновляются автоматически.