RAID-массив — это несколько физических дисков, объединённых так, что система видит их как один диск. Смысл в двух вещах: пережить смерть одного накопителя без остановки сервера и в некоторых конфигурациях читать данные быстрее одиночного диска. Уровень выбирают до заказа машины: на работающем сервере смена уровня почти всегда означает перенос данных и простой. Если вы присматриваете площадку под большие объёмы, начните с подборки VPS под хранилище.
Материал для тех, кто впервые собирает сервер под сайт, 1С, видеонаблюдение или базу данных и упёрся в строку «RAID» в конфигураторе. Разберём пять рабочих уровней с цифрами, сравним аппаратный и программный варианты, соберём зеркало на Linux по шагам, научимся ловить умерший диск и проговорим, почему массив не заменяет резервную копию.
Что такое RAID-массив и от чего он на самом деле защищает
Аббревиатура RAID расшифровывается как «избыточный массив независимых дисков». Контроллер или драйвер ОС принимает обычные запросы на чтение и запись и сам решает, на какой физический накопитель их отправить и что продублировать. Приложению это не видно: оно работает с одним устройством вроде /dev/md0.
Защищает такая схема ровно от одного класса аварий — отказа железа. Диск умирает внезапно или деградирует постепенно, набирая ошибки чтения. В массиве с избыточностью сервер этого не заметит: он продолжит отдавать данные с уцелевших накопителей, а администратор заменит сбойный. Термин разобран в справке: что такое RAID.
Что не лечится массивом: удаление файла человеком, кривая миграция, шифровальщик, ошибка в SQL-запросе, пожар в дата-центре. Во всех этих случаях изменение честно продублируется на все диски — в том числе удаление.
Второй мотив — скорость: запросы к нескольким накопителям обслуживаются параллельно. Одиночный SATA-диск на 7200 об/мин выдаёт 150–200 операций в секунду, четыре таких же в чередовании — уже около 600–800.
Чередование, зеркалирование и чётность: три механизма всех уровней
Любой уровень RAID — комбинация трёх приёмов. Понимая их, вы восстановите логику любой цифры в конфигураторе, даже незнакомой.
Чередование (striping) режет поток данных на блоки по 64–512 КБ и раскладывает по дискам по очереди: первый блок на диск A, второй на B, третий снова на A. Полезный объём равен сумме дисков, скорость растёт, избыточности нет.
Зеркалирование (mirroring) пишет одни и те же данные на два накопителя сразу. Полезный объём равен объёму одного диска, зато потеря любого из пары не приводит к потере информации. Чтение распараллеливается между копиями, запись быстрее не становится.
Чётность (parity) — компромисс. Контроллер считает для группы блоков контрольную сумму операцией XOR (побитовое сложение) и раскладывает её по дискам. Если накопитель выпал, недостающие блоки восстанавливаются вычислением. Платить приходится объёмом одного диска и скоростью записи: каждое изменение требует пересчёта, то есть лишних чтений.
Отсюда правило: чем больше избыточности, тем меньше полезного объёма и медленнее запись. Дальше — уровни с арифметикой на дисках по 4 ТБ.
RAID 0 и RAID 1: два полюса — скорость и надёжность
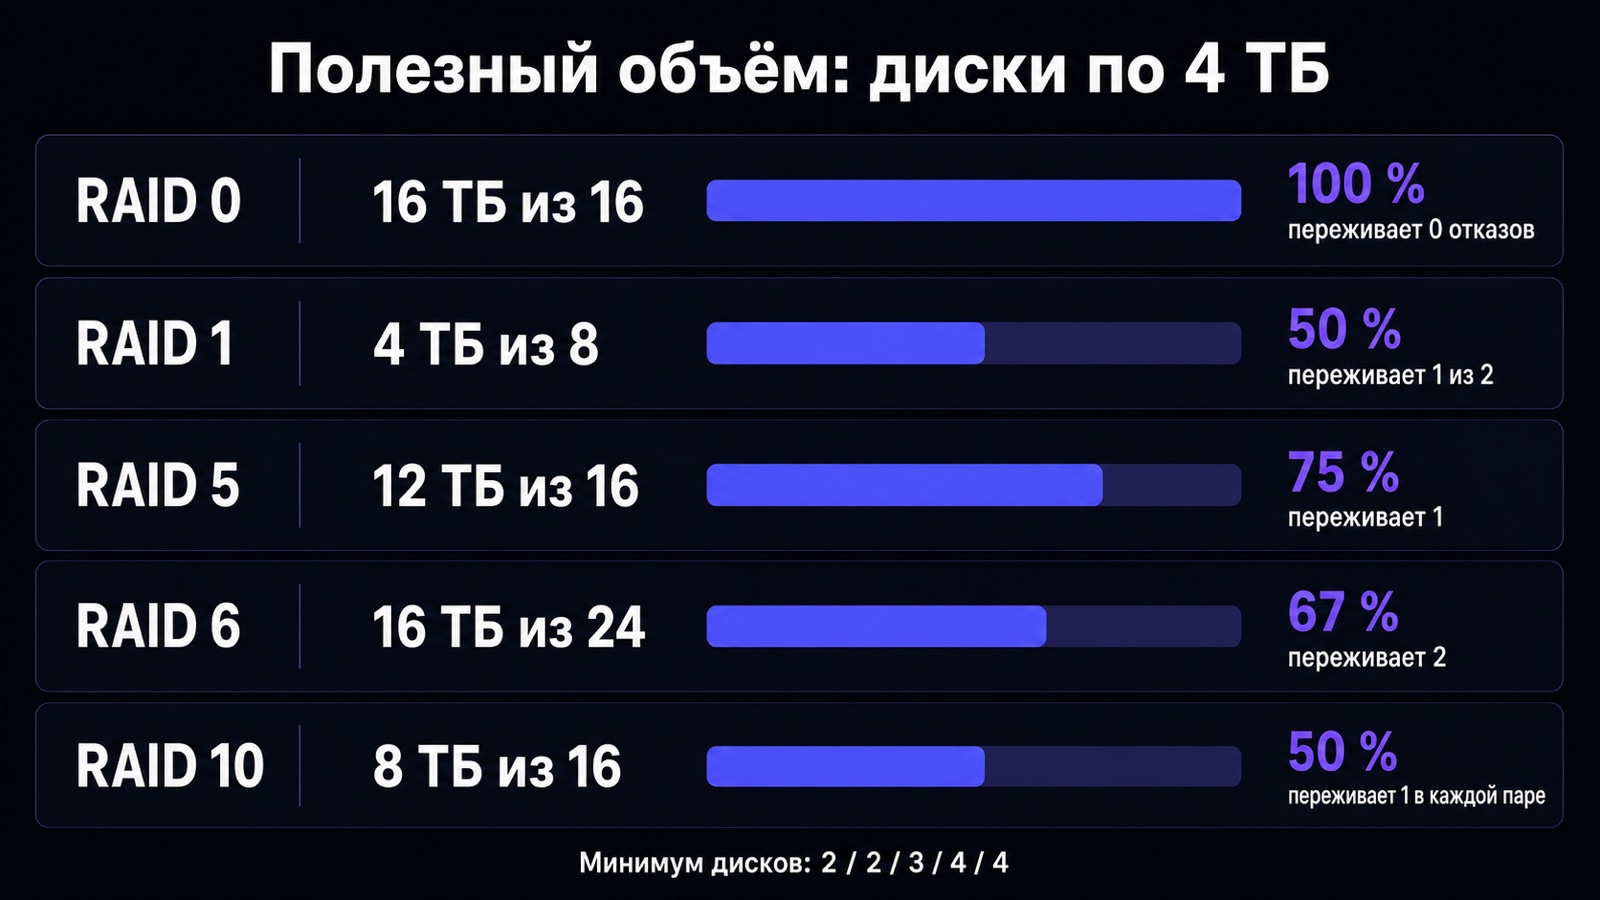
RAID 0 — чистое чередование без избыточности. Четыре диска по 4 ТБ дают 16 ТБ, то есть все 100 % купленной ёмкости, и линейную скорость, близкую к учетверённой. Расплата жёсткая: смерть любого диска уничтожает массив целиком, потому что уцелевшие хранят обрывки файлов без каждого четвёртого блока.
Вероятность аварии растёт с числом дисков. Если шанс отказа одного накопителя за год условно 2 %, то у массива из четырёх он приближается к 8 %. Такой уровень берут только под данные, которые не жалко: кеш, временные файлы рендеринга, промежуточные результаты обработки видео.
RAID 1 — зеркало. Два диска по 4 ТБ дают 4 ТБ полезного объёма: 50 % ёмкости уходит в резерв. Массив переживает потерю одного накопителя из двух и работает без деградации на чтении. Это самый предсказуемый вариант для системного раздела, небольшого сайта, почтового сервера или бухгалтерии.
У зеркала есть недооценённое достоинство — простота восстановления. На уцелевшем диске лежит полная копия файловой системы, её можно смонтировать на другой машине даже без родного контроллера. У массивов с чётностью так не выйдет: без метаданных данные нечитаемы.
RAID 5: минус один диск из объёма и главный риск перестройки
RAID 5 требует минимум трёх дисков и хранит блоки данных вместе с блоками чётности, распределёнными по всем накопителям. Полезный объём равен n−1 дискам: четыре диска по 4 ТБ дают 12 ТБ вместо 16, в резерв уходит 25 %, а не 50 %, как в зеркале. Массив переживает отказ одного диска.
Именно экономия объёма делает этот уровень популярным в бюджетных сборках. Но у него есть слабое место — перестройка. Когда вы вставляете новый диск взамен умершего, контроллер обязан прочитать все данные с оставшихся накопителей и пересчитать содержимое пропавшего. Массив на 12 ТБ перестраивается от 8 до 30 часов.
Все эти часы массив работает без избыточности, под максимальной нагрузкой на чтение, на дисках одного возраста из одной партии. Второй отказ или единственная непоправимая ошибка чтения означает потерю всего массива. На ёмкостях от 8 ТБ на накопитель пятый уровень обычно уже не рекомендуют.
Вывод: RAID 5 уместен на трёх-пяти дисках средней ёмкости под архивы и файловые шары — общие сетевые папки, куда пишут редко. Для баз данных он плох и по скорости — каждая мелкая запись превращается в две операции чтения и две записи.
RAID 6 и RAID 10: уровни под базы данных и нагруженные проекты
RAID 6 — тот же принцип, что и пятый уровень, но с двумя независимыми блоками чётности. Минимум четыре диска, полезный объём равен n−2: шесть дисков по 4 ТБ дают 16 ТБ из 24. Массив переживает отказ двух накопителей и спокойно доживает до конца перестройки. Цена — ещё более медленная запись.
RAID 10 — зеркала, объединённые чередованием. Четыре диска собираются в две зеркальные пары, пары складываются в один быстрый том. Полезный объём — ровно половина, 8 ТБ из 16. Массив переживает отказ одного диска в каждой паре, но гибель обоих накопителей одной пары фатальна.
Десятый уровень берут под PostgreSQL, MySQL, 1С и любые задачи с массой мелких случайных записей. Причина — отсутствие чётности: запись идёт на два диска, никаких лишних чтений и пересчётов. Перестройка тоже дешёвая: копируется один диск из пары, поэтому 4 ТБ восстанавливаются за 5–8 часов.
Какой RAID выбрать для сервера: сравнение уровней в одной таблице
Ниже сведены все пять уровней. Полезный объём считается для дисков по 4 ТБ, чтобы цифры были сопоставимы. Столбец «переживает» — число одновременных отказов, после которых данные ещё целы.
Ориентируйтесь на профиль нагрузки: пишет много и мелко — десятый уровень, хранит и почти не меняет — пятый или шестой.
| Уровень | Дисков минимум | Полезный объём | Переживает отказов | Скорость записи | Типичная задача |
|---|---|---|---|---|---|
| RAID 0 | 2 | 16 ТБ из 16 (100 %) | 0 | Максимальная | Кеш, рендеринг, временные данные |
| RAID 1 | 2 | 4 ТБ из 8 (50 %) | 1 из 2 | Как у одного диска | Система, сайт, почта, 1С офиса |
| RAID 5 | 3 | 12 ТБ из 16 (75 %) | 1 | Низкая на мелких записях | Архивы, файловые шары |
| RAID 6 | 4 | 16 ТБ из 24 (67 %) | 2 | Ниже, чем у RAID 5 | Архивы на дисках от 8 ТБ |
| RAID 10 | 4 | 8 ТБ из 16 (50 %) | 1 в каждой паре | Высокая | Базы данных, нагруженный веб |
Аппаратный RAID или программный: контроллер, mdadm и ZFS
Собрать массив можно двумя способами. Первый — отдельная плата-контроллер с собственным процессором, памятью и батарейкой, которая держит кеш при отключении питания. Операционная система видит готовый том и о дисках ничего не знает.
Второй способ — программный массив средствами самой ОС. В Linux это подсистема mdadm либо файловая система ZFS со встроенными пулами. Отдельная плата не нужна: диски подключаются прямо к материнской, а арифметику считает центральный процессор — это 1–3 % загрузки ядра.
Разница чаще решает в пользу программного варианта. Контроллер быстрее на записи благодаря энергонезависимому кешу, но привязывает к модели: если плата умрёт, читать диски придётся на точно такой же. Программный массив переезжает на любую машину с Linux, а ZFS вдобавок считает контрольные суммы блоков.
| Критерий | Аппаратный контроллер | mdadm | ZFS |
|---|---|---|---|
| Доплата за железо | от 15 000 ₽ за плату | 0 ₽ | 0 ₽ |
| Нагрузка на процессор | Нулевая | 1–3 % на ядро | 5–10 % плюс память |
| Требования к памяти | Своя, от 512 МБ до 2 ГБ | Незначительные | От 8 ГБ RAM на пул |
| Перенос дисков | Нужна такая же плата | Любая машина с Linux | Любая машина с ZFS |
| Контроль целостности | Нет | Нет | Суммы всех блоков |
Как собрать зеркало на Linux: пошаговая инструкция
Разберём частый сценарий — RAID 1 из двух пустых дисков на Ubuntu или Debian. Команды выполняются от root. Все данные на дисках, попавших в массив, будут уничтожены, поэтому сначала убедитесь, что выбрали правильные устройства.
Обратите внимание на предпоследний шаг: без записи конфигурации массив может не собраться после перезагрузки, и сервер уйдёт в аварийную консоль.
- Посмотрите список дисков командой
lsblk— она печатает дерево устройств с размерами. Нужны накопители без разделов, напримерsdbиsdc. - Установите утилиту:
apt install mdadm. Пакет весит около 2 МБ и тянет службу мониторинга. - Создайте массив одной командой (разбор ниже).
- Дождитесь синхронизации и создайте файловую систему:
mkfs.ext4 /dev/md0. - Смонтируйте том (то есть подключите его к каталогу в файловой системе) и пропишите в
/etc/fstabпо UUID — постоянному идентификатору тома. Имена вида/dev/sdbпосле перезагрузки могут смениться, UUID — нет. - Сохраните конфигурацию массива и пересоберите образ начальной загрузки.
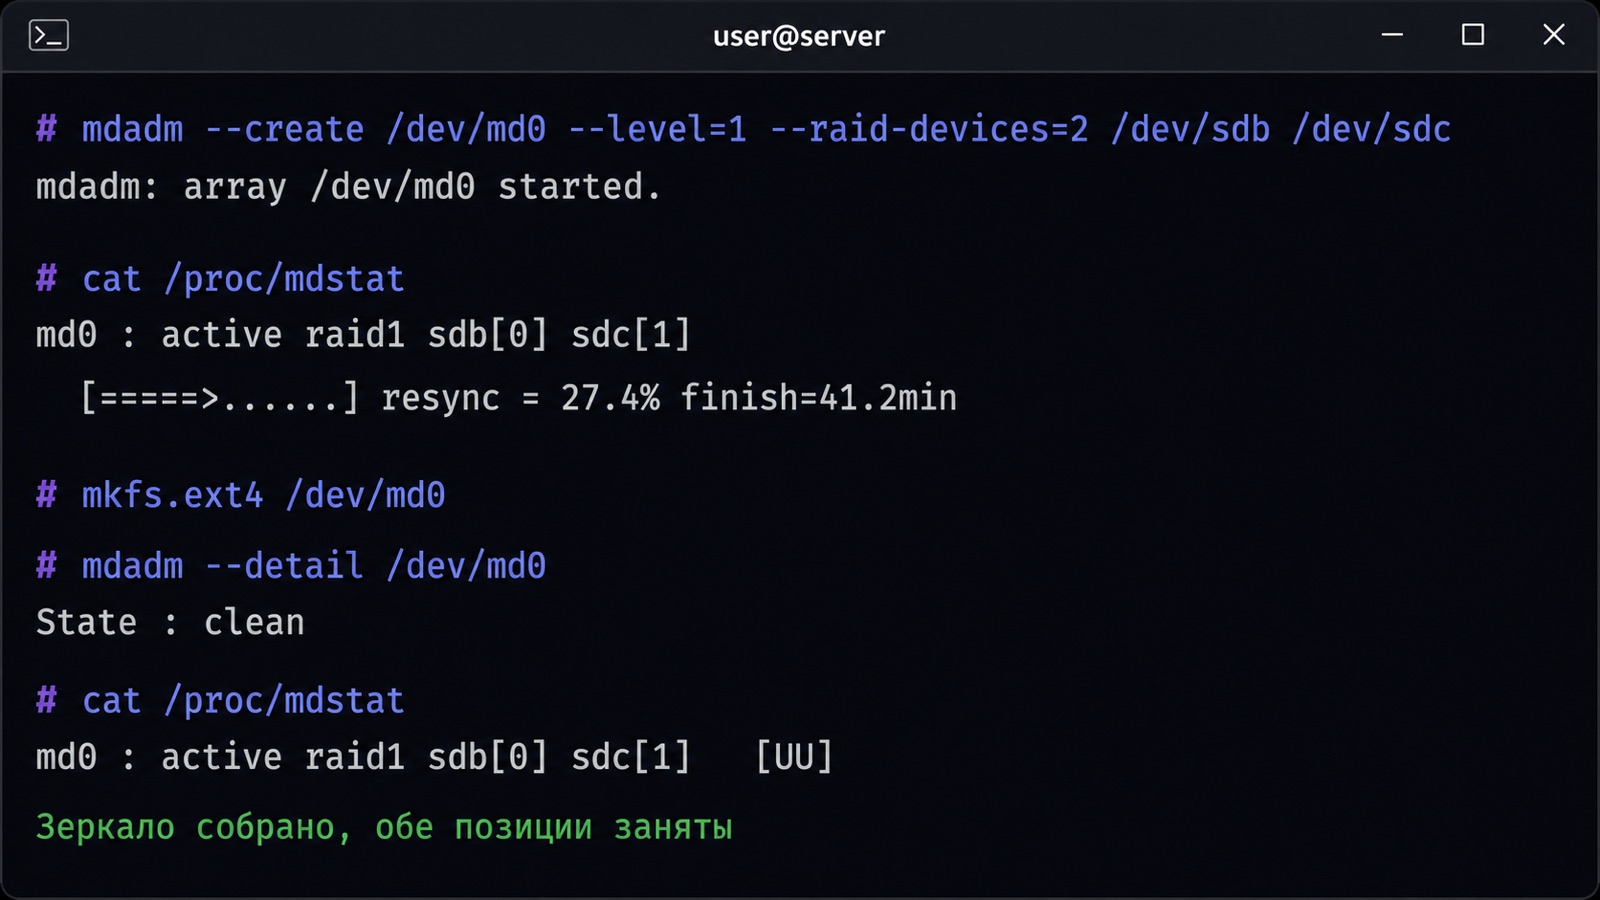
mdadm --create /dev/md0 --level=1 --raid-devices=2 /dev/sdb /dev/sdcЗдесь --create /dev/md0 задаёт имя будущего устройства, --level=1 — уровень массива (поставьте 10 для десятого, 5 для пятого), --raid-devices=2 — сколько накопителей входит в массив, дальше перечислены сами диски.
cat /proc/mdstatФайл /proc/mdstat — живой отчёт ядра о всех массивах. Сразу после создания вы увидите строку вида [=====>......] resync = 27.4% finish=41.2min: зеркало копирует содержимое первого диска на второй. Пользоваться томом можно уже сейчас, скорость будет ниже штатной.
mdadm --detail --scan >> /etc/mdadm/mdadm.conf
update-initramfs -u
Первая строка дописывает описание массива в конфигурационный файл, вторая перепаковывает initramfs — мини-систему, которая стартует до монтирования корня и должна знать, как собрать массив. Пропустите эти команды, и следующая перезагрузка закончится сюрпризом.
Как проверить состояние массива и заменить умерший диск
Диагностику ведут слоями: сначала смотрят на массив целиком, потом на конкретный диск, потом на его физическое здоровье. Такой порядок экономит время — половина «отказов» оказывается выпавшим кабелем.
Первый слой — cat /proc/mdstat. Здоровое зеркало показывает [UU]: обе позиции заняты. Строка [U_] означает, что второй диск выбыл, массив жив, но избыточности больше нет. Отсутствие устройства md0 в выводе говорит, что массив не собрался, — ищите проблему в конфигурации, а не в дисках.
Второй слой — mdadm --detail /dev/md0. Команда печатает состояние (clean, degraded, resyncing), список участников и пометку faulty напротив проблемного накопителя.
Третий слой — smartctl -a /dev/sdb из пакета smartmontools: команда читает встроенную самодиагностику диска. Смотрите на счётчики Reallocated_Sector_Ct (число заменённых сбойных секторов) и Current_Pending_Sector (секторы, которые диск не смог прочитать). Растущее ненулевое значение — приговор накопителю, даже если массив пока в порядке. Замена выполняется тремя командами.
mdadm --manage /dev/md0 --fail /dev/sdb
mdadm --manage /dev/md0 --remove /dev/sdb
mdadm --manage /dev/md0 --add /dev/sdd
После третьей команды начнётся перестройка, её прогресс виден в том же /proc/mdstat. Физически менять накопитель на ходу можно, только если корзина поддерживает горячую замену; на обычной плате сервер придётся выключить.
Почему RAID не заменяет бэкап: правило 3-2-1
Массив дублирует запись в реальном времени — в этом его сила и его ограничение. Стёртая по ошибке папка исчезает со всех дисков за миллисекунды. Шифровальщик перепишет и зеркало, и чётность. Отказ блока питания способен унести все накопители сразу.
Работающая схема описывается правилом 3-2-1: три копии данных, на двух разных типах носителей, одна — за пределами площадки. Для небольшого проекта это выглядит буднично: боевые данные на сервере с RAID 1, ночная копия в хранилище другого провайдера, недельная — на диск в офисе.
Копии обязаны быть версионными, иначе автоматика перезапишет здоровый архив испорченными данными. И восстановление нужно проверять: раз в квартал разверните дамп на тестовой машине и убедитесь, что база поднимается. Настройка расписаний разобрана в гайде как настроить бэкапы VPS.
Разница в назначении: резервная копия возвращает данные на момент снимка, а RAID удерживает сервис в строю прямо сейчас. Вместе они закрывают и отказ железа, и человеческую ошибку.
Сколько дисков нужно и на каком сервере собирать массив
Собственный RAID возможен там, где у вас есть доступ к физическим накопителям, — на выделенном сервере или своём железе. На виртуальной машине массив уже собран провайдером на стороне гипервизора: вы получаете готовый отказоустойчивый диск, не управляя им. Разницу разбирает материал VPS или выделенный сервер.
Минимальные требования по числу дисков: 2 под зеркало, 3 под RAID 5, 4 под RAID 6 и RAID 10. Если задача терпит только короткий простой, заложите пятый диск как горячий резерв — он подхватит место выпавшего автоматически. Тип накопителей влияет не меньше уровня: у HDD дешевле терабайт, у SSD и NVMe в сотни раз выше число операций в секунду. Разбор различий — в гайде NVMe и SSD для сервера.
Если нужен просто надёжный диск без администрирования массива, дешевле взять виртуальную машину: в каталоге 44 площадки, стартовые тарифы начинаются с двузначных сумм.
| Провайдер | Стартовая цена | Младший тариф | Тарифов в каталоге |
|---|---|---|---|
| Cloudcore | от 59 ₽/мес | 1 ядро, 1 ГБ RAM, 10 ГБ NVMe | 12 |
| Hosting-Russia | от 99 ₽/мес | Конфигурации под заказ | — |
| 4VPS | от 110 ₽/мес | 1 ядро, 1 ГБ RAM, 5 ГБ NVMe | 568 |
| HostVDS | от 127 ₽/мес | 1 ядро, 1 ГБ RAM, 10 ГБ NVMe | 12 |
Данные проверены 04.09.2026.
Частые ошибки при сборке и эксплуатации массива
Большинство потерь данных на массивах происходит не из-за выбора уровня, а из-за мелочей вокруг него. Пункты ниже встречаются в каждой второй истории «мы всё потеряли, хотя у нас был RAID».
Отдельно отмечу первый и последний: вместе они дают самый обидный сценарий — массив сообщал о проблеме неделями, но письма уходили в никуда.
- Не настроен мониторинг. Служба mdadm шлёт письма при деградации, но адрес нужно прописать в
/etc/mdadm/mdadm.conf. - Все диски куплены одной партией. Накопители одного возраста часто выходят из строя с разницей в дни.
- RAID 5 на дисках от 8 ТБ: перестройка растягивается на сутки и повышает шанс второго отказа.
- Пропущены
mdadm --detail --scanиupdate-initramfs -u. Массив работает до первой перезагрузки. - Массив считают бэкапом. Нужна отдельная копия вне сервера, желательно у другого провайдера.
- Умерший диск не меняют неделями. Деградированный массив — это обычный одиночный диск без страховки.
Частые вопросы
Можно ли собрать RAID из дисков разного объёма? Технически да, но лишнее место пропадёт: массив выравнивается по самому маленькому накопителю. Пара из дисков на 2 ТБ и 4 ТБ в зеркале даст 2 ТБ полезного объёма.
Насколько RAID 1 замедляет запись? Практически не замедляет: данные пишутся на оба диска параллельно, скорость примерно равна скорости одного накопителя. Чтение, наоборот, ускоряется до полутора-двух раз, потому что запросы распределяются между копиями.
Что делать, если массив перешёл в состояние degraded? Посмотрите mdadm --detail /dev/md0 и определите выпавший диск, затем проверьте его через smartctl. Если ошибок нет, диск возвращают в массив командой --add; если счётчики сбойных секторов растут — меняйте накопитель.
Нужен ли RAID на виртуальной машине? Внутри VPS собирать массив бессмысленно: провайдер уже держит данные на отказоустойчивом хранилище, а два виртуальных диска почти наверняка лежат на одном физическом.
Сколько времени идёт перестройка после замены диска? Зеркало на 4 ТБ восстанавливается за 5–8 часов, RAID 5 на 12 ТБ — от 8 до 30 часов. Всё это время массив работает без запаса прочности, поэтому диски меняют сразу.
Чем ZFS лучше обычного mdadm? Она считает контрольную сумму каждого блока и при чтении замечает искажение данных, которое mdadm пропустит молча. Плюс мгновенные снимки и сжатие на лету. Взамен требуется память: разумный минимум — 8 ГБ RAM на пул.
Можно ли поменять уровень массива без потери данных? mdadm умеет часть преобразований на живой системе, например превратить RAID 5 в RAID 6. Операция долгая и рискованная, поэтому перед ней делают полную копию — а если копия есть, проще пересобрать массив с нуля.
Итог
Выбор сводится к трём сценариям: данные не жалко и нужна скорость — RAID 0, один-два диска и важна предсказуемость — RAID 1, четыре диска и база под нагрузкой — RAID 10. Пятый и шестой уровни оставьте архивам, где запись редкая. И в любом варианте держите отдельную копию по правилу 3-2-1.
Собирать собственный массив имеет смысл там, где вы управляете физическими накопителями. Конфигурации с двумя и более дисками смотрите в разделе выделенные серверы — там собраны предложения площадок каталога с ценами и характеристиками.